

در دنیای امروز که موتورهای جستجوی مبتنی بر هوش مصنوعی آرامآرام جایگزین سرچ سنتی گوگل میشوند، قوانین بازی بهینهسازی سایت در حال تغییر است. در عصر نوین GEO (بهینهسازی برای موتورهای مولد)، دیگر تلاش برای رتبه گرفتن روی یک کلمه کلیدی خاص معنایی ندارد؛ میدان نبرد واقعی در درک این موضوع نهفته است که سیستمهای هوش مصنوعی چگونه پشت صحنه، یک سوال طبیعی و چندبعدی کاربر را کالبدشکافی کرده و به دهها زیر-کوئری موازی خرد میکنند.
مطلب مرتبط: جئو چیست؟ راهنمای جامع بهینهسازی سایت برای هوش مصنوعی
در این میان، مکانیزم «کوئری فناوت» دقیقاً همان مرز باریکی است که مشخص میکند آیا محتوای شما شانس حضور در پاسخهای ترکیبی هوش مصنوعی را دارد یا محکوم به فراموشی مطلق در اعماق وب است.
در این مقاله، فرآیند کوئری فَناوت را کالبدشکافی میکنیم تا بتوانید استراتژی محتوای خود را با ساختار موتورهای پاسخدهی همگام کنید و سایت خود را برای عصر هوش مصنوعی آماده کنید.
چرا مفهوم کوئری فن اوت را باید جدی بگیریم
قبلاً جستجو در وب یک فرآیند ساده و خطی بود؛ یک عبارت را سرچ میکردیم، گوگل 10 لینک آبی جلویمان میگذاشت و خودمان باید با باز کردن تبهای مختلف، اطلاعات را تکهتکه کنار هم میچیدیم تا به جواب برسیم.
اما حالا موتورهای پاسخدهی هوش مصنوعی این کار دستی و زمانبر را حذف کردهاند. در ساختار جدید، موتور جستجو مثل یک دستیار پژوهشیِ همهفنحریف عمل میکند و هسته اصلی این تغییر، همین Query Fan-Out است. وقتی شما یک سوال چندبعدی میپرسید، سیستم پشت صحنه آن را کالبدشکافی کرده، دهها جستجوی موازی و همزمان انجام میدهد و در نهایت یک پاسخ آماده، منسجم و بدون نیاز به کلیک اضافی (Zero-Click) به شما تحویل میدهد.
این یعنی زمین بازی سئو عوض شده است؛ دیگر قرار نیست برای رتبه 1 در صفحه نتایج بجنگید، بلکه باید تلاش کنید محتوایتان به عنوان یکی از منابع این پاسخ تلفیقی انتخاب شود.
اینترنت از محتوای تکراری و هوش مصنوعی پُر شده است. در زیشاوِب، دانش و تجربه واقعی شما را به محتوایی منحصربفرد تبدیل میکنیم.
سفارش تولید محتواکوئری فن اوت (Query Fan-Out) چیست؟
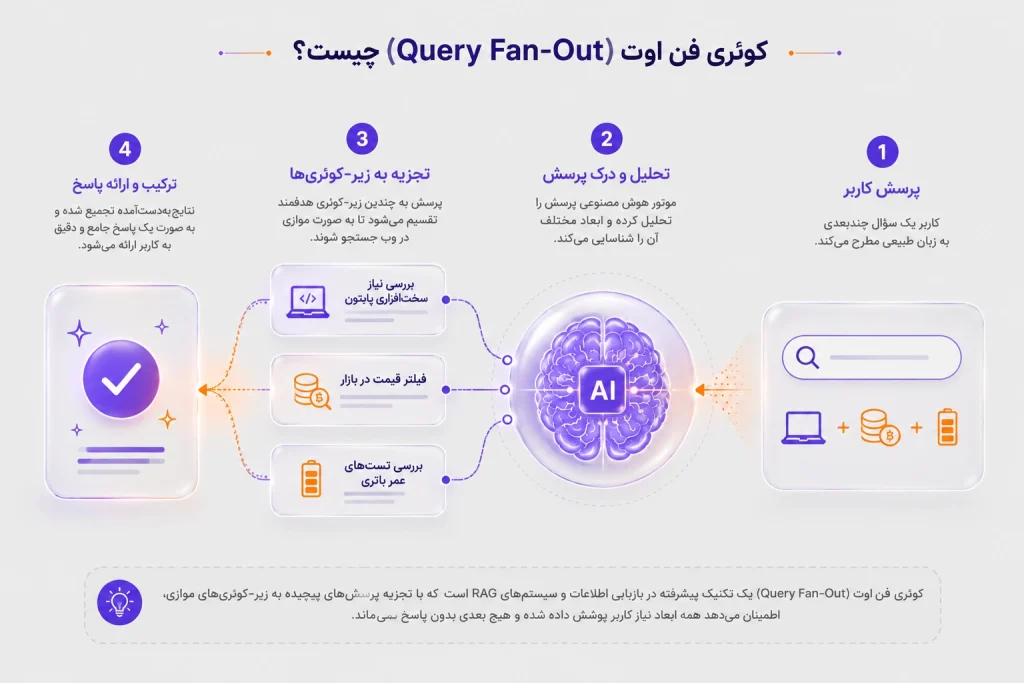
بیایید با یک سناریوی واقعی موضوع را ساده کنیم. فرض کنید قصد خرید یک لپتاپ برای برنامهنویسی پایتون دارید، با بودجه زیر ۷۰ میلیون تومان و البته شارژدهی باتری بالا.
در جستجوی سنتی، شما هرگز نمیتوانستید این سوال چندبعدی را در یک کادر جستجو بنویسید و مستقیم به جواب نهایی برسید. مجبور بودید فرآیند را خودتان مرحلهبهمرحله جلو ببرید: ابتدا سرچ میکردید «سختافزار مورد نیاز برای پایتون»، بعد در یک تب دیگر دنبال «لیست لپتاپهای زیر ۷۰ میلیون بازار» میگشتید و در نهایت، تکتک مدلهای مدنظر خود را با جستجوی عباراتی مثل «تست باتری لپتاپ X» بررسی میکردید. یعنی باز کردن دهها تب مختلف و تلفیق ذهنیِ تکههای پازل توسط خودتان.
اما در دنیای جستجوی هوش مصنوعی، شما کل این خواسته را در قالب یک پرامپت طبیعی مینویسید. موتور پاسخدهی هوش مصنوعی پشت صحنه دقیقاً همان کاری را میکند که شما قبلاً دستی انجام میدادید؛ یعنی این سوال چندبعدی را کالبدشکافی کرده و به چندین مأموریت یا زیر-کوئری (Sub-query) موازی مثل بررسی نیاز سختافزاری پایتون، فیلتر قیمتی بازار و بررسی تستهای عمر باتری تقسیم میکند. به این فرآیندِ تجزیه، جستجوی همزمان و موازی در وب، کوئری فناوت (Query Fan-Out) میگویند.
در واقع، کوئری فناوت یک تکنیک پیشرفته در مهندسی بازیابی اطلاعات (Information Retrieval) و سیستمهای RAG (تولید محتوا با بازیابی کمکی) است. این مکانیزم به جای اینکه پرامپت محاورهای و طولانی کاربر را مستقیماً و به صورت یکباره به موتور جستجو بفرستد، آن را کالبدشکافی کرده و به مجموعهای از سوالات هدفمند، عمیق و موازی تبدیل میکند تا مطمئن شود هیچ بعد پنهانی از نیاز کاربر بیپاسخ نخواهد ماند.
برای درک دقیقتر تفاوت میان رویکرد سنتی گوگل با این فرآیند انقلابی مبتنی بر هوش مصنوعی، مقایسه زیر را بررسی کنید:
| ویژگی | جستجوی سنتی (Traditional Search) | جستجو با کوئری فناوت (AI Search) |
| ورودی کاربر | کلمات کلیدی کوتاه، ایستا و تلگرافی (مانند: “بهترین لپتاپ”) | پرامپتهای طولانی، طبیعی، چندبعدی و سوالی |
| نحوه پردازش و جستجو | یک جستجوی واحد و تطابق کلمه به کلمه با صفحات نمایه شده | تجزیه پرامپت به ۱۰ تا دهها زیر-پرسش (Synthetic Sub-queries) و جستجوی موازی |
| دقت بازیابی منبع | معرفی کل صفحه وب (Page-Level) بر اساس اعتبار دامنه و سئو | استخراج پاراگرافها و قطعات دقیق اطلاعاتی (Passage/Chunk-Level) از سراسر وب |
| ساختار پاسخ نهایی | ارائه لیستی از دهها لینک آبی برای کلیک و بررسی دستی کاربر | تلفیق متنها، جداول و مقایسهها در قالب یک پاسخ منسجم و ارجاعدهنده |
| نرخ کلیک (CTR) و ترافیک | نرخ کلیک بالا (جنگ بر سر رتبههای ۱ تا ۳ صفحه اول) | نرخ کلیک مستقیم پایین به دلیل حل نیاز کاربر در همان صفحه (Zero-Click) |
| هدف نهایی سیستم | هدایت کاربر به مناسبترین وبسایت برای یافتن پاسخ | ترکیب حقایق از چندین منبع برای ساخت بهترین پاسخ بدون نیاز به خروج کاربر |
کوئری فن اوت دقیقاً چگونه کار میکند؟
طراحی یک استراتژی تولید محتوای موفق بدون شناخت دقیق چرخه حیات یک پرامپت در سیستمهای هوش مصنوعی غیرممکن است. وقتی شما سوالی چندبعدی را از یک هوش مصنوعی جستجوگر میپرسید، پشت صحنه یک مأموریت اطلاعاتی چندمرحلهای آغاز میشود. این فرآیند پویا و موازی به طور کلی شامل ۶ مرحله کلیدی است که در جدول زیر به تصویر کشیده شده است:
| گام | مرحله فنی | رویداد اصلی و عملکرد سیستم | خروجی مأموریت |
| ۱ | تحلیل قصد کاربر (Intent Analysis) | بررسی میزان پیچیدگی سوال و شناسایی نیازهای صریح و پنهان کاربر | نقشه راه جستجو و پردازش محتوا |
| ۲ | تولید پرسشهای ساختگی (Synthetic Query Generation) | خُرد کردن سوال اصلی به چندین زیر-پرسش دقیق، عمیق و موازی با متدولوژیهای مختلف | لیستی از کوئریهای فرعی و هدفمند |
| ۳ | جستجوی موازی در وب (Parallel Retrieval) | ارسال همزمان تمام زیر-کوئریها به موتورهای جستجو در کسری از ثانیه | دریافت صدها صفحه وب خام و مرتبط |
| ۴ | قطعهبندی و ارزشگذاری معنایی (Chunking & Embedding) | تبدیل صفحات طولانی وب به پاراگرافهای کوچک (Chunks) و سنجش شباهت ریاضی آنها با نیاز کاربر | مجموعهای از بندهای متنی با پتانسیل پاسخدهی بالا |
| ۵ | رتبهبندی مجدد و فیلترینگ (Re-ranking & Filtering) | راستیآزمایی دادهها، سنجش تازگی محتوا و اولویتبندی بهترین قطعات با الگوریتمهای رتبهبندی مجدد | گلچین نهایی مستندترین پاراگرافهای وب |
| ۶ | تلفیق و ارجاعدهی (Synthesis & Citation) | بازنویسی پاسخ نهایی به قلم مدل زبانی (LLM) و درج لینک منبع روی تکتک ادعاها | پاسخ منسجم، جامع و مستند در صفحه نتایج |
1- تحلیل قصد کاربر (Intent Analysis)
در قدم اول، هوش مصنوعی پرامپت کاربر را از نظر پیچیدگی، نیاز به اطلاعات زنده (مانند اخبار جدید، قیمت بورس، آب و هوا) و اهداف پنهان (Implicit) بررسی میکند. اگر سوال ساده باشد (مثلاً “پایتخت فرانسه کجاست؟”)، فناوت رخ نمیدهد؛ اما اگر سوال تحلیلی و مقایسهای باشد، فرآیند آغاز میشود.
2- تولید پرسشهای ساختگی (Synthetic Query Generation)
- همارز یا معادل (Equivalent): سیستم سوال را با کلمات کلیدی مترادف بازنویسی میکند تا مقالاتی که با ادبیات دیگری نوشته شدهاند را از دست ندهد.
مثال: «بهترین لپ تاپ مناسب پایتون تا ۷۰ میلیون» - کلانتر یا گستردهتر (Broader): رفتن به یک لایه بالاتر برای درک بهتر مفاهیم پیرامون نیاز اصلی کاربر.
مثال: «حداقل مشخصات سختافزاری برای برنامهنویسی پایتون» - موازی (Parallel): بررسی زوایای جانبی که کاربر مستقیماً نپرسیده اما تصمیمگیری او به آنها وابسته است.
مثال: «مقایسه سیستمعامل ویندوز و مک برای برنامهنویسی پایتون» - جزییتر یا محدودتر (Narrower): تمرکز روی جزئیات ریزتر، قطعات فنی خاص یا برندها.
مثال: «بهترین پردازندههای لپتاپ زیر ۷۰ میلیون برای کارهای سنگین» - شخصیسازیشده (Personalized): بهینهسازی سوال بر اساس موقعیت جغرافیایی، زمان جستجو، تاریخچه و دستگاه کاربر.
مثال: «فروشگاههای معتبر خرید لپتاپ در تهران با گارانتی اصلی» - مقایسهای (Comparative): قرار دادن کاندیداهای احتمالی در برابر هم برای سنجش دقیقتر ارزش خرید.
مثال: «مقایسه عمر باتری مکبوک ایر M2 با لپتاپهای ویندوزی همقیمت» - ضمنی و ناگفته (Implicit): کشف و تحلیل نیازهای ناگفتهای که احتمالاً کاربر فراموش کرده در پرامپت خود بپرسد.
مثال: «آیا برای برنامهنویسی پایتون به کارت گرافیک مجزا نیاز داریم؟» - تازگی محتوا (Recency): جستجوی آخرین وضعیت بازار، قیمتهای زنده و مدلهای جدید عرضهشده در سال جاری.
مثال: «جدیدترین لپتاپهای بازار ایران زیر ۷۰ میلیون تومان در سال جاری»
3- جستجوی موازی (Parallel Retrieval)
تمام زیر-پرسشهای تولید شده به طور همزمان و در عرض چند میلیثانیه به زیرساخت موتور جستجو (مانند Bing برای ChatGPT یا پایگاه داده گوگل برای AI Mode) فرستاده میشوند. جستجوی همزمان کلید سرعت بالای این سیستمهاست.
4- قطعهبندی و ارزشگذاری (Chunking & Embedding)
صفحات وب پیدا شده به قطعات کوچک متنی (معمولاً ۲۰۰ تا ۵۰۰ توکن) به نام Passage یا Chunk تقسیم میشوند. سپس این قطعات به بردارهای ریاضی تبدیل شده و شباهت معنایی آنها با زیر-کوئریها سنجیده میشود. در این مرحله، اعتبار کل صفحه فدای کیفیت اطلاعات همان یک پاراگراف میشود!
5- رتبهبندی مجدد و فیلترینگ (Filtering & Ranking)
هوش مصنوعی با استفاده از الگوریتمهایی نظیر RRF (Reciprocal Rank Fusion) قطعاتی که در چندین زیر-جستجو تکرار شده و رتبه بالایی آوردهاند را بالا میکشد. همچنین فاکتورهایی مثل تازگی محتوا (که طبق آمار ۲۵٪ در پاسخهای هوش مصنوعی اولویت بیشتری دارد) و میزان تطابق دادهها با حقایق (Grounding Confidence) بررسی میشوند.
6- تلفیق و ارجاعدهی (Synthesis & Citation)
در نهایت، مدل زبانی پاسخ یکپارچه را با کنار هم چیدن تکههای اطلاعاتی برگزیده مینویسد و به وبسایتهایی که مستقیماً از پاراگرافهای آنها استفاده کرده است، لینک ارجاع (Citation) میدهد.
تفاوتهای کلیدی بین پلتفرمهای مختلف هوش مصنوعی در اجرای Query Fan-Out
پلتفرمهای بزرگ هوش مصنوعی رفتار متفاوتی در تجزیه و بازیابی اطلاعات دارند که در جدول زیر به صورت فنی و مقایسهای آورده شده است:
| پلتفرم هوش مصنوعی | رفتار الگوریتمی در Fan-out | حساسیت به تازگی (Freshness) | تمرکز در انتخاب منابع | نحوه نمایش ارجاع (Citations) |
| گوگل Gemini (Advanced / AI Mode) | بسیار تهاجمی و عمیق: یک پرامپت را به دهها و گاهی صدها زیر-جستجوی موازی تبدیل میکند تا فرضیات مختلف را بررسی کند. | بسیار بالا: برای رویدادهای زنده و اخبار روزانه بهسرعت کوئریهای تازه میسازد. | ترجیح میدهد دادهها را با استفاده از وبسایتهای مرجع و دامنههای با اتوریتی بالا (مثل ویکیپدیا یا سایتهای دولتی) تایید کند. | ارجاعهای چندگانه در قالب شماره یا آیکونهای کوچک در انتهای هر ادعا. |
| چتجیپیتی (ChatGPT Search) | متعادل و هدفمند: پرامپت را به ۲ تا ۵ کوئری بهینهشده برای موتور جستجوی بینگ تبدیل میکند و از جستجوهای شاخهای بیهوده خودداری میکند. | متوسط به بالا: برای سوالات نیازمند داده زنده، فورا فاز سرچ را فعال میکند. | تمایل بالایی به ارجاع به وبسایتهای رسانهای بزرگ، سایتهای تخصصی بررسی محصول و فرومهای عمومی دارد. | درج مستقیم نام وبسایت در قالب کلمات کلیدی لینکشده در بدنه پاسخ. |
| پرپلکسیتی (Perplexity AI) | پویا و گامبهگام (Iterative): ابتدا چند جستجوی اولیه انجام میدهد و بر اساس پاسخهای دریافتی، کوئریهای فرعی بعدی را میسازد. | بسیار بالا: سیستم بازیابی آن تمرکز زیادی روی استخراج آخرین بهروزرسانیها دارد. | علاقه شدید به منابع تخصصی دست اول، کدهای گیتهاب، مقالات علمی و شبکههای اجتماعی تخصصی مثل ردیت و توییتر. | نمایش برجسته و بزرگ منابع در بالای پاسخ به همراه ارجاع عددی در متن. |
تله بزرگ «کلمات کلیدی دمدراز افراطی» در سئو چیست؟
بزرگترین اشتباه استراتژیک متخصصان سئو در مواجهه با فرآیند کوئری فناوت این است که تلاش میکنند برای تکتک زیر-پرسشهای کشفشده در این سیستمها، صفحات جداگانه بسازند. به این کار Hyper Long-Tail Trap یا تله کلمات کلیدی دمدراز افراطی میگویند. چرا این استراتژی کارساز نیست؟
- ماهیت احتمالی و متغیر: زیر-کوئریهای تولید شده توسط هوش مصنوعی کاملاً داینامیک و مبتنی بر شانس هستند. اگر یک پرامپت را سه بار تکرار کنید، هوش مصنوعی هر بار زیر-پرسشهای متفاوتی میسازد (تحقیقات نشان میدهد کمتر از ۲۷٪ زیر-کوئریها در دفعات مختلف ثابت میمانند).
- حجم جستجوی صفر: این عبارات هرگز توسط انسانها تایپ نمیشوند؛ آنها کلماتی ساختگی (Synthetic) هستند که مدل زبانی برای خودش تولید کرده است و عملاً هیچ ترافیک مستقیمی در ابزارهایی مثل Ahrefs یا کیوردپلنر ندارند.
- دویدن دنبال یک هدف متحرک: تلاش برای بهینهسازی محتوا برای این زیر-کوئریهای گذرا، مانند دویدن به دنبال یک بادبادک در طوفان است. شما امروز محتوایی را برای یک زیر-کوئری خاص بهینهسازی میکنید، اما فردا با آپدیت شدن مدل زبانی، سیستم مسیر کاملاً متفاوت و زیر-کوئریهای جدیدی را برای پاسخ به همان پرامپت انتخاب میکند.
چگونه محتوای خود را برای کوئری فن اوت بهینهسازی کنیم؟ (۷ استراتژی عملی)
برای اینکه در پاسخهای هوش مصنوعی حاصل از فَن اوت حضور داشته باشید و استناد (Citation) دریافت کنید، باید استراتژی سئوی خود را از ساختار سنتی به ساختار مدرن زیر تغییر دهید:
1- تمرکز روی اعتبار موضوعی (Topical Authority) و ایجاد خوشهها
به جای تولید صفحات مجزای پراکنده، حول محور موضوع اصلی خود کلاسترهای محتوایی (Content Clusters) بسیار قوی ایجاد کنید. هاب یا ستون اصلی باید به گونهای باشد که تمامی موجودیتهای فرعی، مقایسهها و مباحث پیرامون موضوع را پوشش دهد تا سیستم RAG برای هر زیر-پرسش کثیری که تولید میکند، پاسخ را در هاب یا زیرصفحات شما بیابد.
2- بهینهسازی در سطح پاراگراف (Passage-Level Optimization)
محتوای خود را به صورت ماژولار (بخش بخش و مستقل) بنویسید. هر پاراگراف شما باید به تنهایی معنا داشته باشد و بتواند به عنوان یک جواب مستقل توسط هوش مصنوعی استخراج (Chunk) شود. از نوشتن مقدمههای طولانی و بیمعنی بپرهیزید و مستقیم سر اصل مطلب بروید.
3- پوشش ماتریسی ویژگیهای موجودیتها (Entity-Attribute Coverage)
هوش مصنوعی روابط بین موجودیتها (کالاها، خدمات، اشخاص) و صفتهای آنها (قیمت، مزایا، معایب، کاربردها) را تحلیل میکند. جدول یا ماتریسی از این ویژگیها در سایت خود داشته باشید. برای مثال اگر درباره “بهترین لپتاپهای برنامه نویسی” مینویسید، جدول مقایسه مشخصات سختافزاری، شارژدهی، قیمت و وزن را به صورت شفاف قرار دهید.
4- ساختاردهی به دادهها با اسکیما (Schema Markup)
استفاده از اسکیمای مختلف مانند اسکیمای FAQ، اسکیمای محصول (Product) و اسکیماهای تخصصی صنعتی به هوش مصنوعی کمک میکند تا اطلاعات ارزشمندی مانند قیمت، نویسنده معتبر، مراحل انجام کار و پرسش و پاسخها را بدون نیاز به پردازش پیچیده متن، مستقیماً از کد صفحه شما استخراج کند.
5- به کارگیری فرمتهای محبوب هوش مصنوعی
موتورهای پاسخدهی ساختارهای زیر را برای استخراج داده بسیار ترجیح میدهند:
- جداول (Tables): برای مقایسه ویژگیها و قیمتها.
- لیستهای نشانهدار و عددی (Lists): برای مراحل، ویژگیها و مزایا/معایب.
- پرسش و پاسخ صریح (Q&A): تعریف کوتاه مفاهیم در ابتدای هر بخش.
6- تقویت همهجانبه فاکتورهای E-E-A-T
هوش مصنوعی برای بررسی میزان وثوق و اعتبار محتوا به فاکتورهای تجربه (Experience)، تخصص (Expertise)، اعتبار (Authoritativeness) و اعتماد (Trustworthiness) حساس است. داشتن بیوگرافی نویسنده با لینک به شبکههای اجتماعی علمی، ارجاع به آمارهای رسمی و مقالات دانشگاهی، احتمال حذف نشدن محتوای شما را در مرحله فیلترینگ هوش مصنوعی به شدت بالا میبرد.
7- بهینهسازی فایل llms.txt برای رباتهای هوش مصنوعی
همانطور که رباتهای سنتی از robots.txt استفاده میکنند، کراولرهای هوش مصنوعی مدرن به دنبال فایلی به نام llms.txt در ریشه سایت شما هستند. این فایل خلاصهای متنی و ساختاریافته از مهمترین بخشهای وبسایت شما را به زبانی ساده در اختیار مدلهای زبانی میگذارد تا در فرآیند فناوت سریعتر با ساختار وبسایت شما آشنا شوند.
البته تیم سرچ گوگل در راهنمای رسمی بهینهسازی گوگل برای موتورهای مولد صراحتاً اعلام کرد که برای حضور در AI Overviews و AI Mode، نیازی به ایجاد فایل llms.txt نیست اما تقریبا همزمان با انتشار این سند راهنما، گوگل در آپدیت جدید ابزار lighthouse خودش معیارهای agentic Browsing را معرفی کرده است که یکی از این معیارها، وجود فایل llms.txt در سایت است.
چگونه موفقیت خود را در این ساختار جدید اندازهگیری کنیم
در دنیای سرچ هوش مصنوعی، معیارهای سنتی مانند “جایگاه کلمه کلیدی در گوگل” و یا “تعداد کلیک” کارایی ندارند. شما باید سنجههای (Metrics) زیر را ردیابی کنید:
- نرخ استناد (Citation Rate): درصد دفعاتی که وبسایت شما در پاسخ به پرامپتهای حوزه تخصصیتان توسط هوش مصنوعی به عنوان منبع ذکر میشود.
- سهم از استنادها (Share of Citations): تعداد ارجاعهای وبسایت شما تقسیم بر کل ارجاعهای موجود در یک پاسخ هوش مصنوعی.
- نرخ انتخاب پاراگراف (Passage Selection Rate): بررسی اینکه محتوای شما پس از بازیابی اولیه چقدر توانسته در فیلترهای نهایی هوش مصنوعی دوام بیاورد و به پاسخ نهایی راه یابد.
- جایگاه در لیست ارجاع (Citation Position): ارجاعهای بالاتر شانس کلیک بسیار بیشتری دارند. تلاش کنید جزو ۳ لینک اول معرفی شده در پاسخ هوش مصنوعی باشد.
جمعبندی و نقشه راه آینده
با ظهور هوش مصنوعی و نفوذ هرچه بیشتر آن در زندگی روزمره ما، رفتار و نحوه تعامل افراد در حوزه جستجوی اطلاعات به کلی در حال دگرگون شدن است.
در گذشته، کاربران برای یافتن پاسخهای خود مجبور بودند کوئریهای مختلفی را در اینترنت سرچ کنند، بر اساس آن کلمهها به وبسایتهای مختلف برسند، تکتک آنها را باز کرده و شروع به مطالعه و مقایسه دستی اطلاعات کنند تا در نهایت به جمعبندی برسند. اما در دنیای جستجوی هوش مصنوعی، زمین بازی به کلی تغییر کرده است. امروزه مخاطب سوال خود را که معمولاً یک عبارت طولانی، چندبعدی و طبیعی (Long-tail) است از هوش مصنوعی میپرسد؛ سپس هوش مصنوعی بر اساس مکانیزم کوئری فَناوت (Query Fan-Out)، آن پرسش را کالبدشکافی کرده، جستجوهای فرعی و موازیِ متعددی میسازد، پاسخها را از سورسهای معتبر مختلف دریافت کرده و پس از تلفیق، در قالب یک جواب یکپارچه به کاربر ارائه میدهد.
در این دنیای جدید، تولید محتوا به شکل و سبک سابق هرگز وبسایت شما را به موفقیت نمیرساند و شما ناگزیر به اتخاذ یک رویکرد کاملاً جدید هستید. در دنیای سرچ هوش مصنوعی، صرفاً تولید «محتوای خوب» کافی نیست؛ بلکه:
- محتوا باید تنیده در تجربه واقعی و کاملاً منحصربهفرد باشد تا دلیلی قوی به هوش مصنوعی برای ارجاع به شما بدهد.
- باید بر روی وبسایت خود خوشههای محتوایی منسجم بسازید تا به تمام شاخههای احتمالی که فرآیند فَناوت برای یک پرامپت میسازد، پاسخ دهید.
- باید متنهای خود را در سطح پاراگرافها و به صورت ماژولار بهینهسازی کنید تا به راحتی توسط عاملهای هوشمند و سیستمهای RAG قابل قطعهبندی و بازیابی باشد.
آینده وب، بهینهسازی برای ماشینهایی است که برای انسانها جستجو میکنند. سئوی مدرن هنر فریب دادن خزندهها نیست؛ هنر تبدیل شدن به معتبرترین و خواناترین پاسخ در مسیر مکانیز کوئری فَناوت سیستمهای هوش مصنوعی است.
اینترنت از محتوای تکراری و هوش مصنوعی پُر شده است. در زیشاوِب، دانش و تجربه واقعی شما را به محتوایی منحصربفرد تبدیل میکنیم.
سفارش تولید محتوا